[딥러닝] 역전파의 대안? FF 알고리즘 (Forward-Forward Algorithm) 이해와 Two-Tower 최적화
제프리 힌튼이 제안한 FF 알고리즘(Forward-Forward Algorithm)의 원리와 기존 역전파(Backpropagation)의 한계를 알아보고, Two-Tower 아키텍처를 적용한 추론 최적화 과정을 탐구한다.
2023년 7월 자기주도창의전공 과목에서 다루었던 FF 알고리즘에 대해서 쉽게 풀어서 이해하고 탐구해본다.리즘 (Forward-Forward Algorithm) 이해와 Two-Tower 최적화
Reference
1. 기존 MLP의 문제점
처음 인공지능을 구현할 때, 인간의 뉴런 시냅스에서 영감을 얻어서 구현되었다.
가장 기본적인 MLP(Multi Layer Perceptron) 구조를 살펴보면 모델의 Output과 실제 정답을 비교해서 loss를 계산하고, Backpropagation(역전파)을 통해서 Output Layer부터 시작해서 Input Layer 쪽으로 학습을 계산하게 된다. 그런데 실제 인간의 뇌에서 시각까지의 과정을 예를 들어 봤을 때, MLP 처럼 역전파와 같은 과정이 이루어지지 않는다. 그리고 만약 MLP에서 레이어의 개수가 많아지게 된다면, 뒷쪽 레이어의 역전파가 되기 전까지 기다려야하는 오버헤드가 발생할 수 있고, 층이 깊어질수록 기울기 소실 문제(Gradient Vanishing)도 발생한다.
2. FF-Algorithm이란?
그래서 FF-Algorithm(Forward-Forward)은 기존의 MLP에서 발생했던 문제점을 개선해보고자 각 레이어가 독립적으로 업데이트 되고, Goodness Function이라는 개념을 제시했다.
먼저 ff-algorithm은 이전 레이어의 error를 기다리지 않는다는 철학을 가지고 있기 때문에, 이를 위해 각 레이어는 독립적으로 학습을 진행하게 된다.
역전파를 하지 않기 때문에 활성값(Activation)이 폭발하지 않도록 정규화(Normalization)을 진행한다. 아래의 식처럼 벡터를 벡터의 크기로 나누어 벡터의 방향만 남기게 된다.
\[x_{direction} = \frac{x}{||x||_2 + \epsilon}\]
정규화를 함으로써 논문에서 언급한 “정보는 벡터의 크기가 아닌 방향에 있다”는 원칙을 반영한다.
논문에서 뉴런의 활성도를 구현하기 위해서 Goodness라는 활성도 개념을 제시했다. Goodness는 아래와 같이 제곱 평균을 통해 구한다.
\[G(x) = \sum_{i=1}^{n} x_i^2\]
먼저 FF-Algorithm으로 학습을 진행하려면, Positive 데이터와 Negative 데이터가 필요하다. 학습을 할때 positive 데이터는 goodness를 증가하도록, negative 데이터로는 goodness를 낮추는 방식으로 학습을 진행한다. 이때 임계값(threshold)을 정해서 이를 기준으로 크게 하거나 작게 만드는 Softplus 형태의 Loss함수를 사용한다.
\[Loss = \log(1 + e^{-(g_{pos} - \theta)}) + \log(1 + e^{(g_{neg} - \theta)})\]
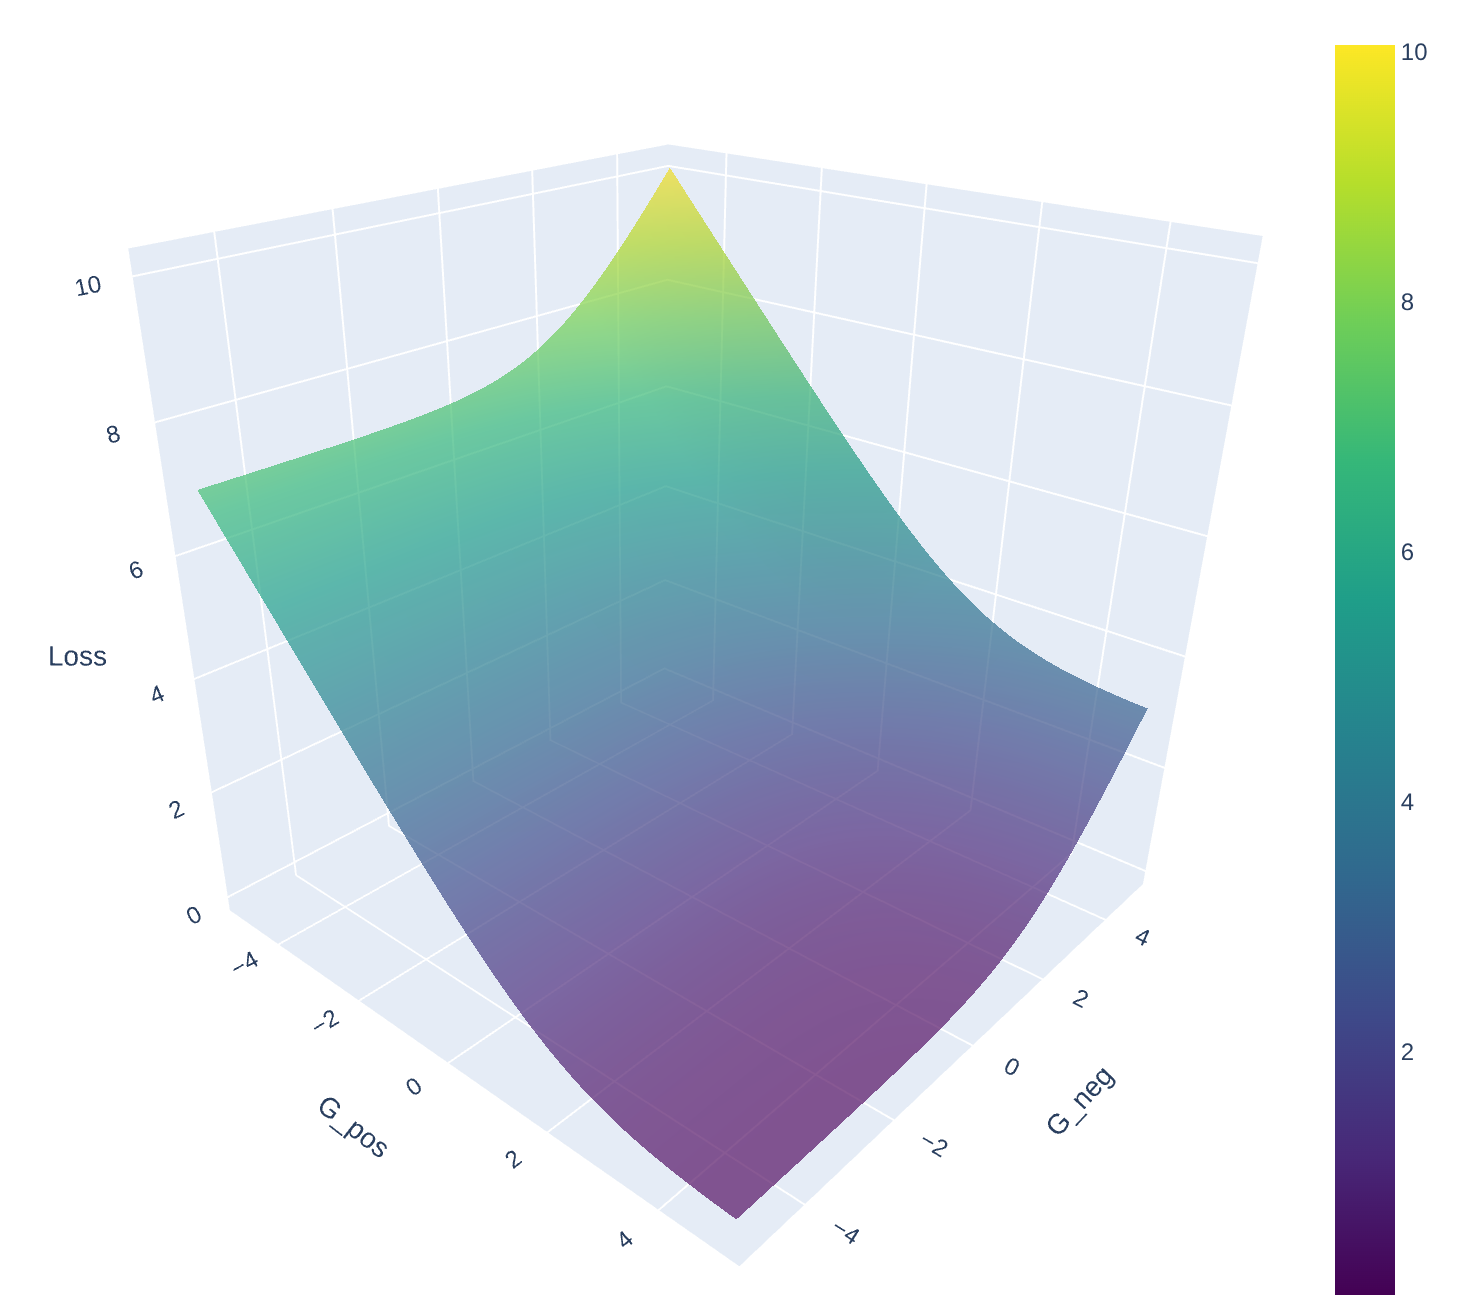 Loss Function
위 그래프를 보면 positive Goodness가 증가할수록, negative Goodness가 줄어들수록 최종적인 loss가 줄어드는 것을 볼 수 있다.
3. 데이터 전처리 (Positive, Negative Data Preprocessing)
Classification - Supervised-Learning 대해서만 다룸
앞서 언급했듯이 ff 알고리즘을 통해 학습을 하려면 positive 데이터와 negative 데이터가 있어야한다.
| Type | Definition |
|---|---|
| Positive Data | Label과 Data가 서로 일치하는 Data |
| Negative Data | Label과 Data가 서로 일치하지 않는 Data |
논문에서는 MNIST 데이터를 가지고 설명하고 있다. 기본적으로 MNIST 데이터는 28x28의 크기의 0-9의 숫자 이미지다. 논문에서 두 가지 타입의 데이터를 만들기 위해 0부터9까지의 one-hot-encoding 형태의 10개의 픽셀을 이미지 좌측상단에 삽입한다.
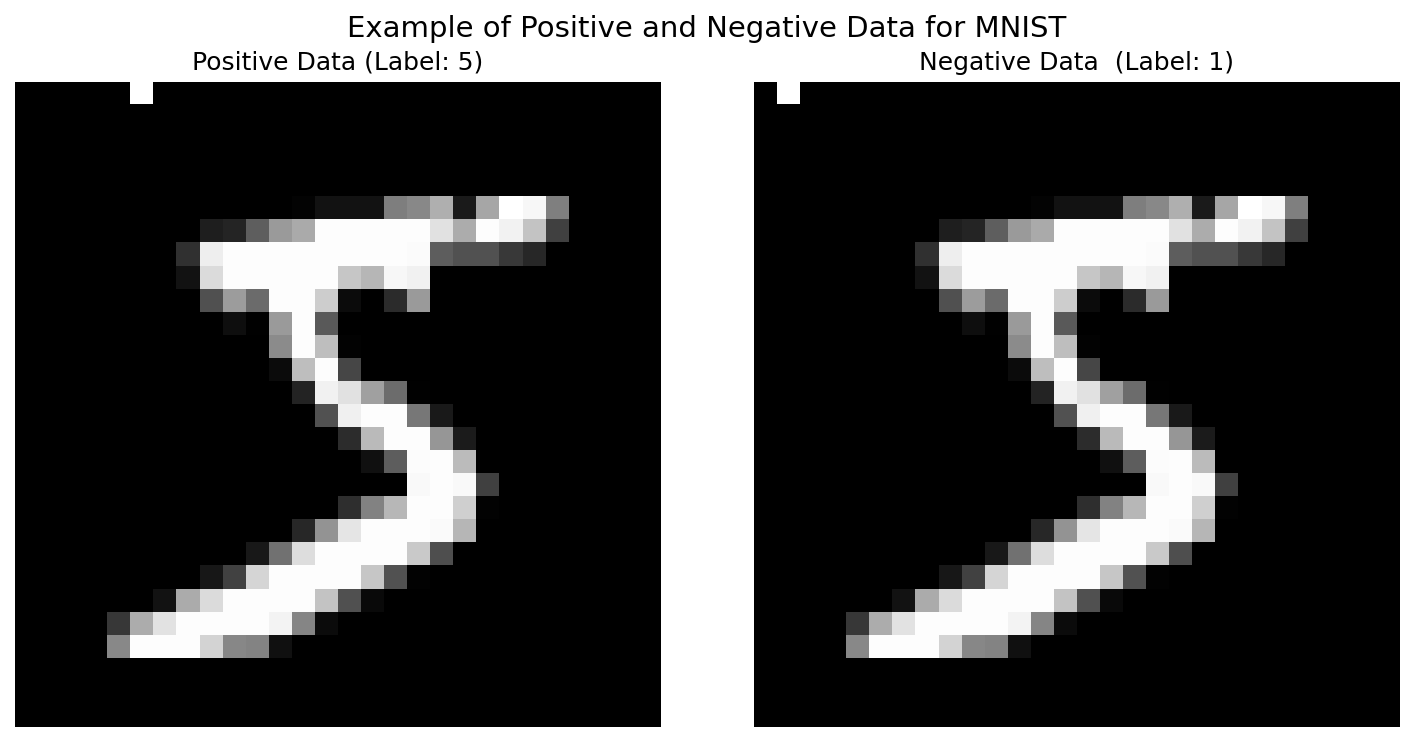 Example: Positive and Negative Data
위와 같이 Positive 데이터의 경우, 이미지 A의 숫자가 5면, 5번째 픽셀을 1로 나머지는 0으로 채우고, negative 데이터의 경우에는 5가 아닌 랜덤한 숫자 하나를 골라 삽입한다. 이렇게 두 가지 데이터로 잘 분리해서 준비한다.
4. 학습 및 추론 (Train and Inference)
필자는 실제 구현할 때 [784, 500, 500] 크기의 모델을 만들어서 구현했기 때문에, 여기에 맞춰서 설명함
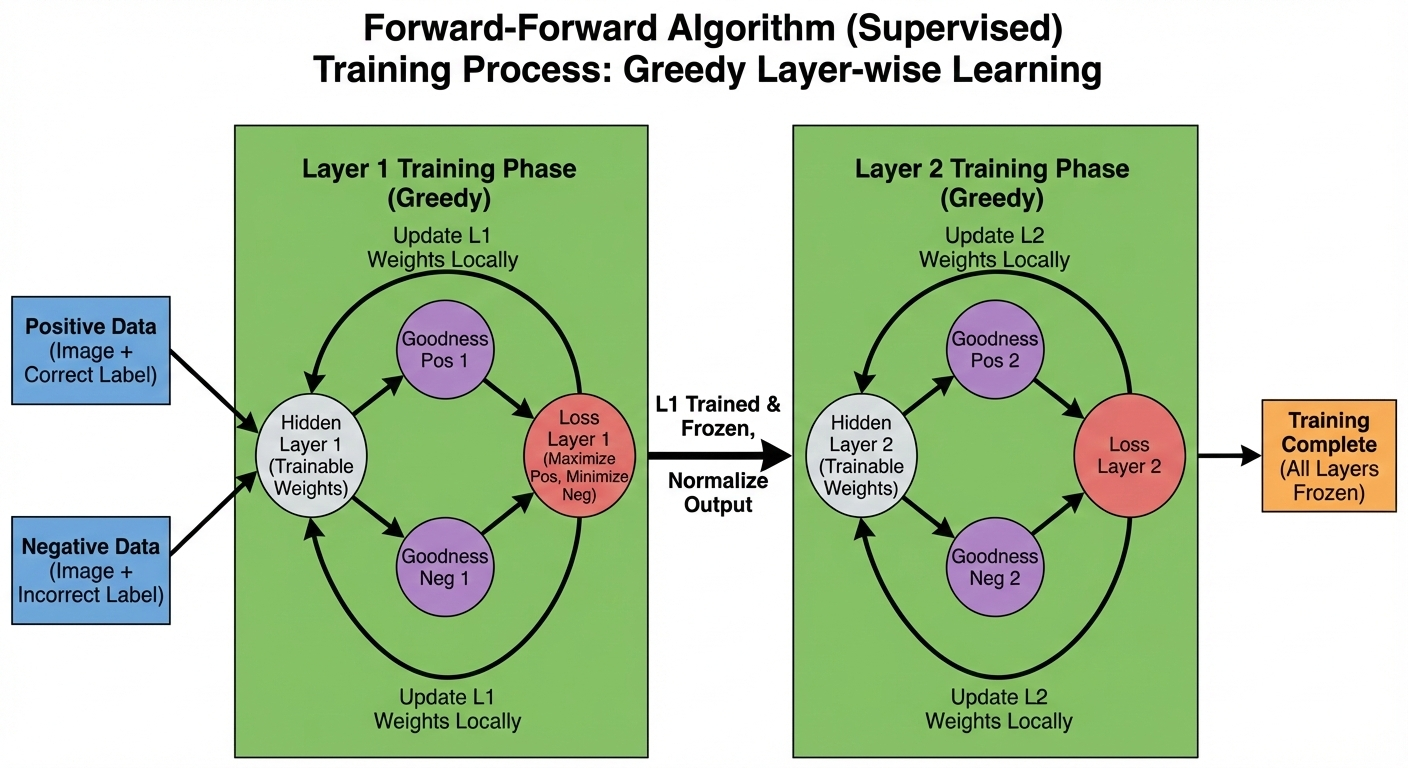 Train Proccess
앞서 설명한 대로, 각 레이어는 positive 데이터는 goodness를 키우도록 학습하고, negative 데이터는 goodness를 줄이도록 학습한다.
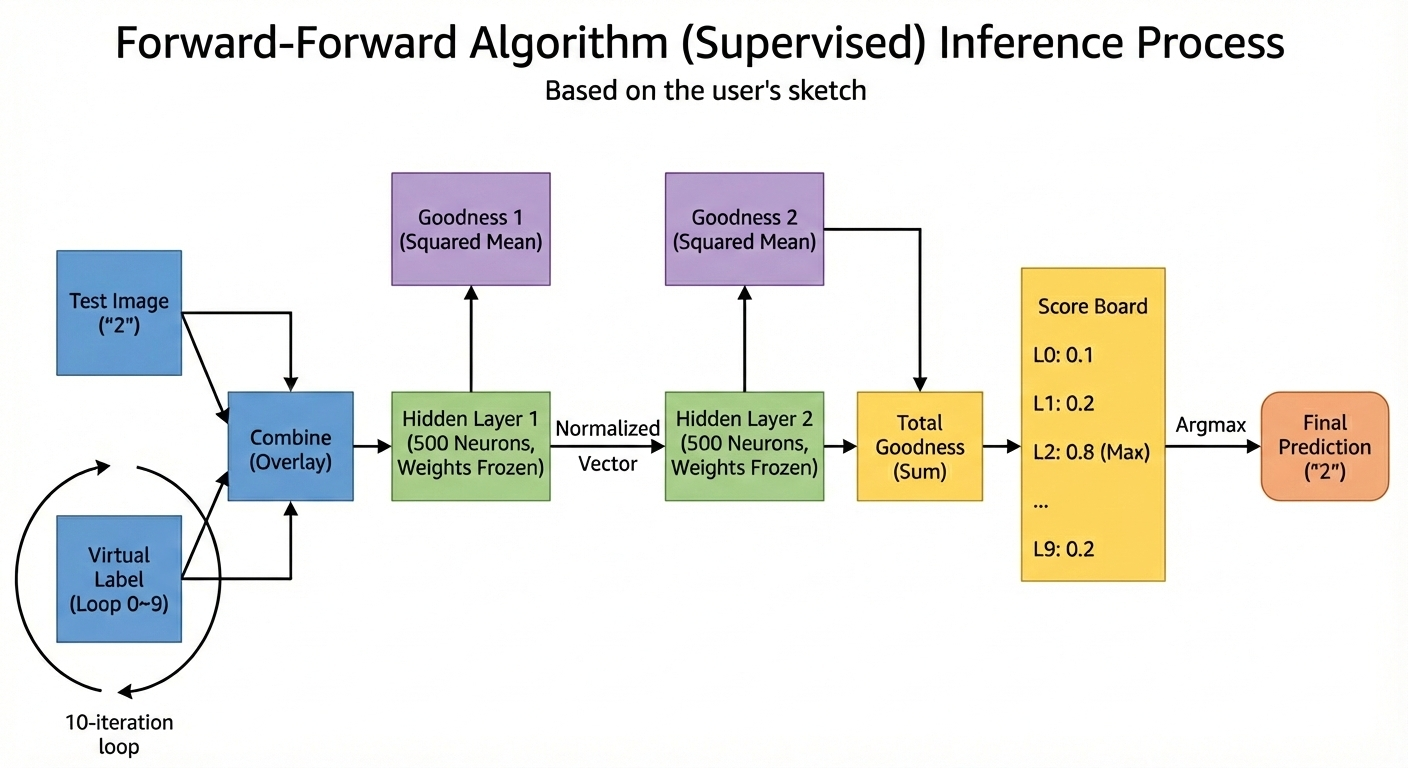 Inference Proccess
추론을 할 때는, 각 라벨 후보에 대해 이미지를 모든 레이어에 통과시킨 후 각 레이어에서 산출된 goodness를 합산하고, 합산 값이 가장 큰 라벨을 최종 추론 결과로 선택한다. 예를 들어 A라는 이미지가 무슨 숫자인지 추론하려고 한다. 그러면 A 이미지에 0부터 9까지의 라벨을 삽입한 이미지들을 준비한다 (총 10개). 그리고 각 이미지들을 모델에 모두 통과시켜 각 라벨링된 이미지의 goodness 중 가장 큰 값을 해당 숫자로 추론하게 된다.
학습 방법의 가능성
여기서 한 가지 의문점이 생길 수 있다. ff 알고리즘에서 레이어는 각각 업데이트 된다고 했다. 만약에 epoch가 1000이라고 가정한다면 학습할 수 있는 두 가지 가능성이 생긴다.
- 한 레이어를 1000번 학습한 뒤, 그 다음 레이어를 1000번 학습한다.
- 전체 모델이 학습하는 것을 한 번으로 하고 이 과정을 1000번 반복한다.
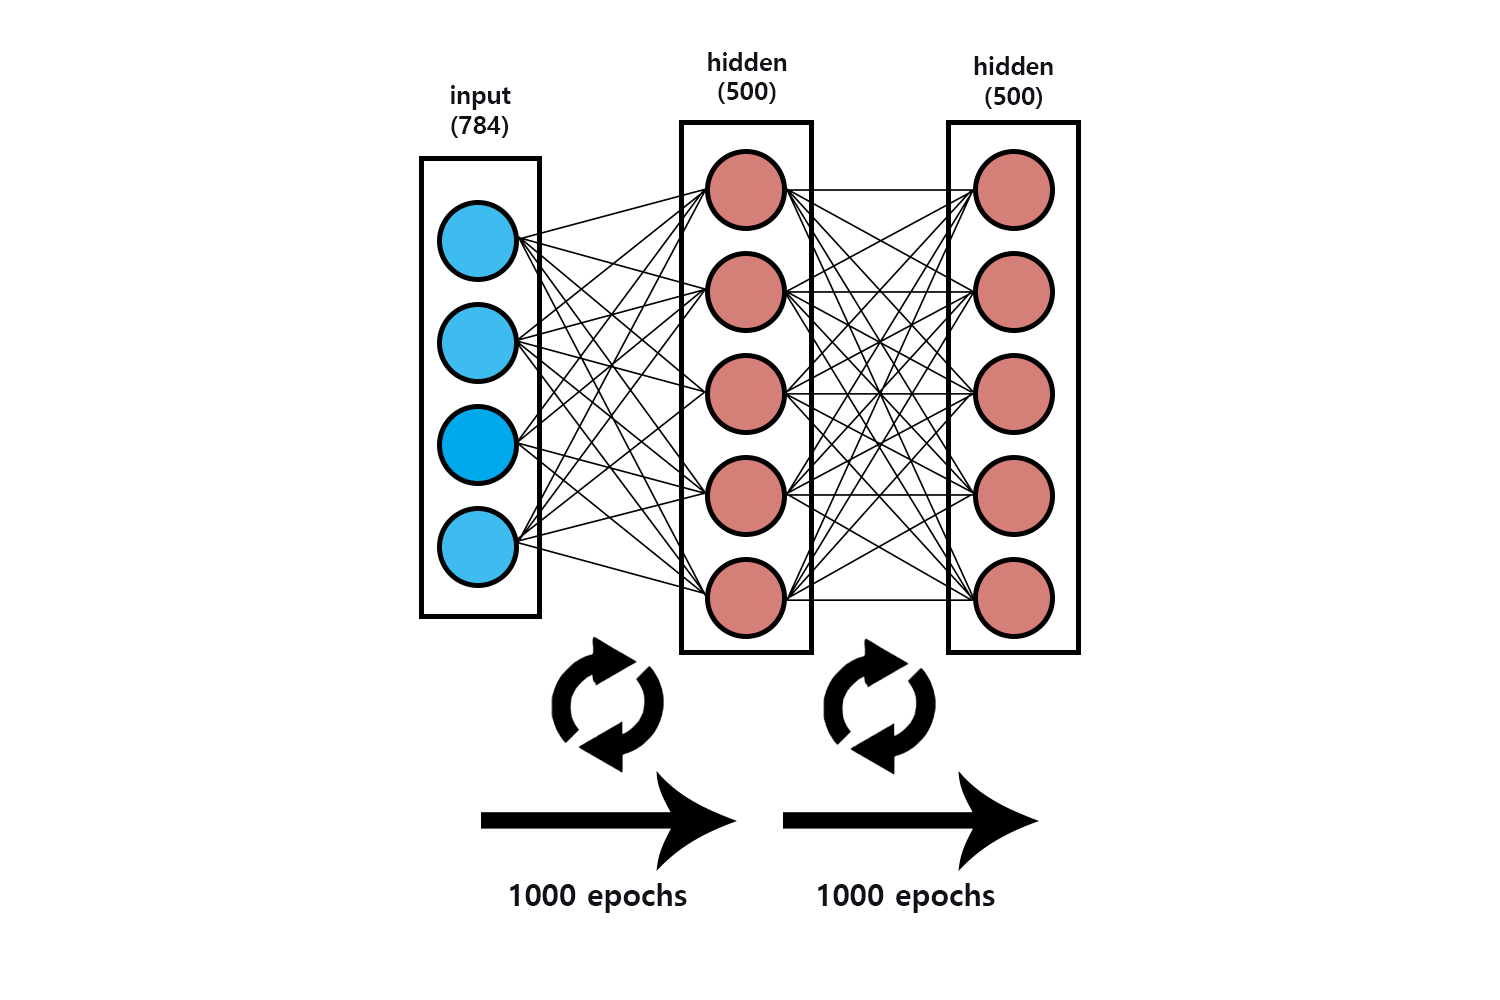 1번 학습 방법
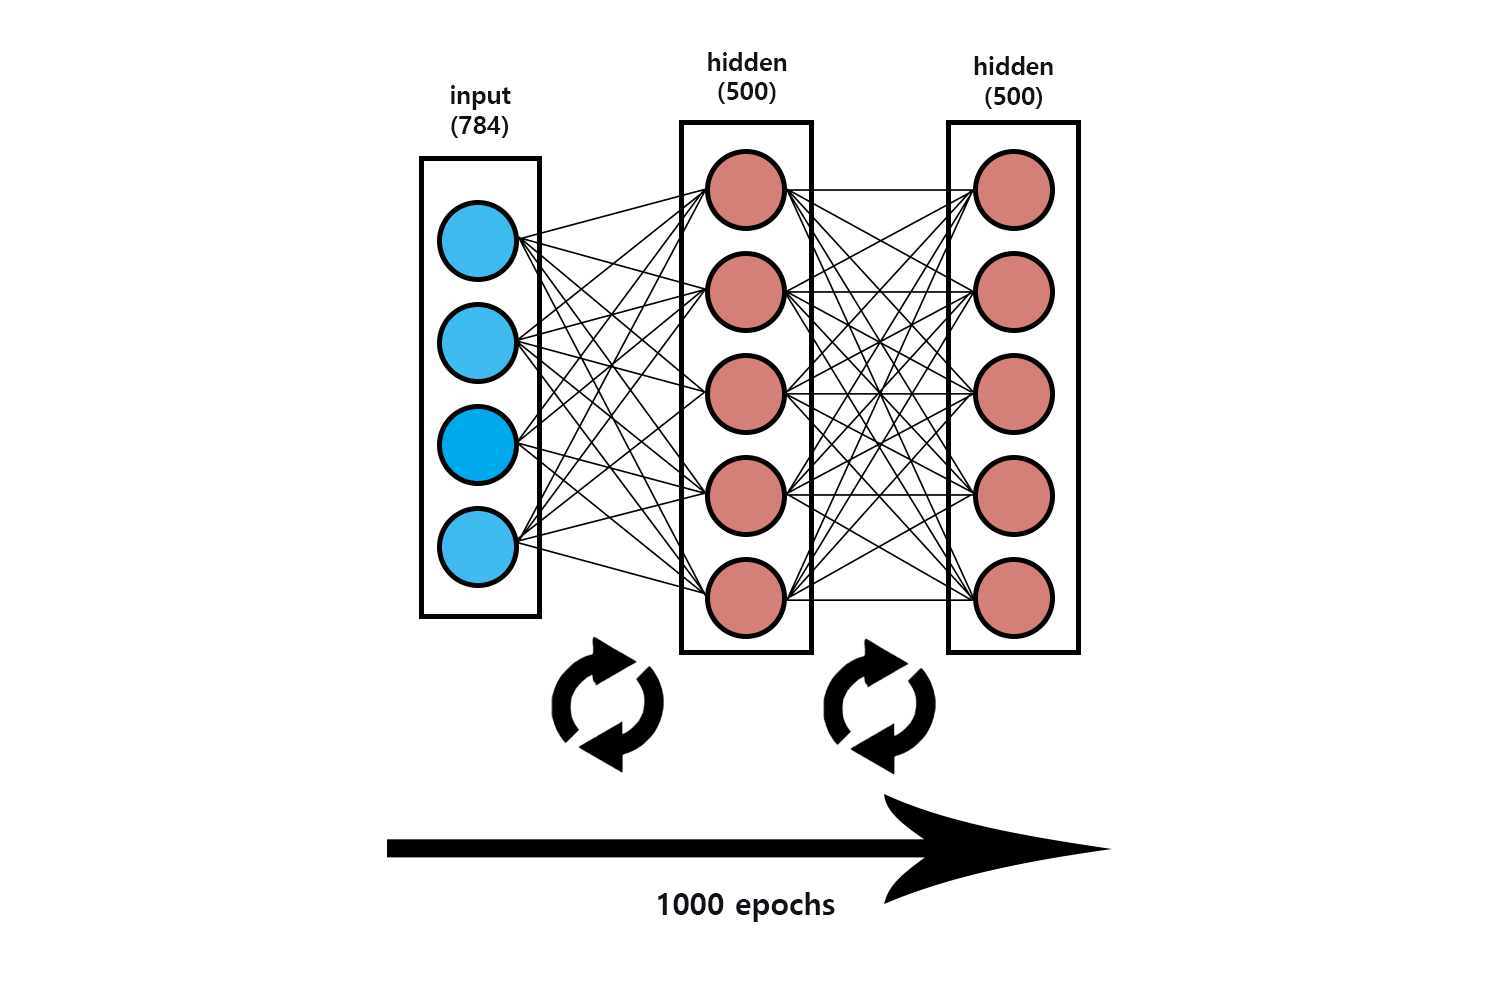 2번 학습 방법
논문에서 정확히 어떻게 학습을 진행했다라는 구체적인 내용은 없지만, “greedy multi-layer learning procedure” 라는 표현을 사용하고 있다. 이는 아래층의 파라미터를 먼저 목표치까지 도달한 후에 값을 고정하고, 그 출력값을 다음 층의 입력으로 사용한다는 근거가 될 수 있다. (논문에서는 2000개의 ReLU를 가진 4개의 은닉층을 60 epoch로 학습했을 때 1.36% test error에 달성했다고 한다.)
개선해보기
기존의 분류 모델에서 추론을 하려면 해당 이미지에 0-9의 숫자 라벨을 삽입한 10개의 이미지를 통과시켜야한다. 이렇게 되면 첫 10개의 픽셀을 제외한 나머지의 부분의 픽셀들은 똑같이 10번 통과되게 된다.또한 원본 이미지의 픽셀 일부를 덮어씌워야 하므로 원본 데이터의 정보 손실도 발생한다. 이를 개선하고자 네트워크 구조를 Two-Tower 방식을 생각해 보았다.
실제 AI 모델을 활용하기 위해서는 연산의 캐싱과 재사용이 필수적이다. 따라서 이미지와 라벨을 각자 경로를 타는 방식을 제안했다.
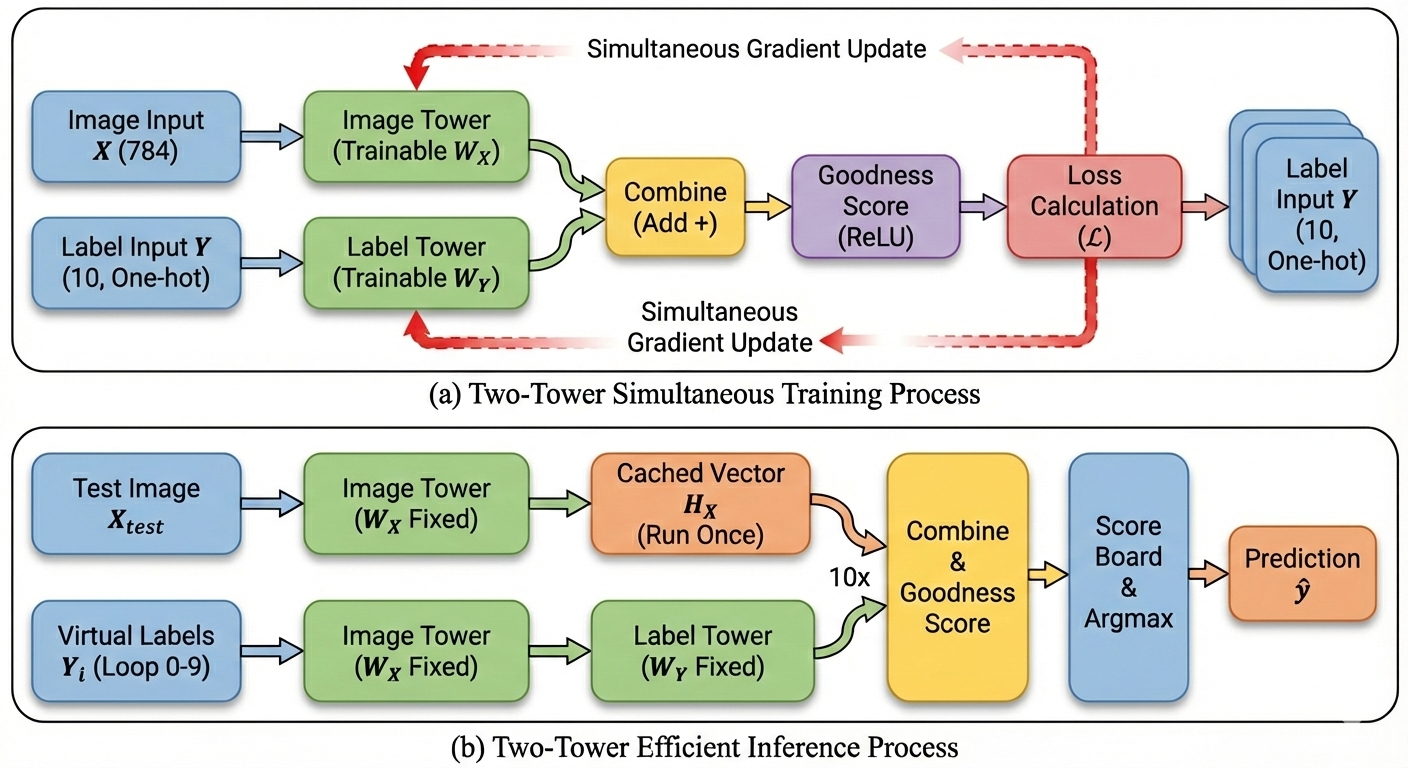 Two-Tower Architecture
먼저 이미지(784)와 라벨(10)은 각각 독립적인 선형레이어를 통과하여 특징 벡터로 변환이 된다. 그 후 변환된 벡터는 중간 단계에서 요소별 덧셈을 통해서 합쳐지고, 이것으로 goodness와 loss를 계산하여 두 타워의 가중치가 동시에 업데이트된다.
이렇게하면 추론과정에서 효율성이 크게 향상된다. 기존에는 이미지(784)를 10번 통과시켜야했지만 지금은 딱 한 번만 수행해서 결과 벡터를 메모리에 저장해둔다. 그리고 0부터 9까지의 라벨(10)을 10번 통과시키고, 미리 저장해둔 이미지 결과 벡터와 더하기만 하면 10개의 goodness 점수를 얻을 수 있다.
결과적으로 가장 큰 비용이 발생하는 이미지에 대한 연산을 10회에서 1회로 줄임으로써 추론 연산량을 약 9배 감소시켰고, 원본 이미지 픽셀을 훼손할 필요도 없어졌다.
5. 마무리
제프리 힌튼 교수가 제안한 Forward-Forward 알고리즘은 오차를 뒤로 전달하는 역전파에 의존하는 기존 딥러닝과 달리, 철저히 생물학적 타당성에 기반하여 설계되었다. 인간의 뇌가 시각과 개념을 분리된 케이블로 받아들이지 않는다는 철학 아래, 논문에서는 이미지 원본 픽셀 일부를 지우고 라벨을 강제로 덮어씌우는 오버레이 방식을 채택했다. 이는 네트워크가 정방향으로만 데이터를 통과시키며 스스로 데이터의 흥분도(Goodness)를 판단하게 만드는 생물학적으로 우아한 접근법이었다.
그러나 이 오리지널 방식을 실제 컴퓨터 시스템 환경에 구현해 본 결과, 비효율성을 내포하고 있고 정보 손실의 문제도 불가피했다. 이러한 병목 현상을 해결하고자, 본 프로젝트에서는 이미지와 라벨을 억지로 하나의 텐서에 섞지 않고 각각 독립된 경로로 특징을 추출하는 투-타워(Two-Tower) 아키텍처를 새롭게 고안하여 적용했다. 그 결과, 원본 데이터의 훼손을 막아 무손실 학습을 달성함과 동시에, 추론 과정의 연산량을 획기적으로 감축하는 성과를 얻을 수 있었다.
물론 이러한 구조적 개선 역시 명확한 한계를 지닌다. 연산 효율성을 극대화하는 과정에서 힌튼 교수가 처음 증명하고자 했던 ‘단순하고 순수한 뇌의 모방’이라는 본래의 철학에서는 다소 멀어지게 되었다. 또한, 철저히 분류(Classification) 연산을 빠르게 하기 위해 인위적으로 최적화된 아키텍처이므로, 향후 비디오 예측이나 자율 주행과 같은 연속적인 비지도 학습(Unsupervised Learning) 상황으로 확장하기에는 구조가 너무 경직되어 있다는 단점이 존재한다.
결론적으로 이번 구현과 개선 과정은 자연을 모방하는 순수 과학과, 한정된 자원 위에서 모델을 구동해야 하는 공학(Engineering) 사이의 간극을 직접 확인하는 계기가 되었다. 새로운 알고리즘을 무작정 수용하는 데 그치지 않고, 시스템의 병목을 찾아내어 실제 서비스에 적용 가능할 법한 최적화된 아키텍처로 직접 발전시켜 본 경험은 구조적 효율성을 비판적으로 사고하게 만드는 밑거름이 될 것이다.